10MB가 부족하다
연어버스는 버스의 잔여 좌석을 예보하는 서비스입니다. 메모리가 1 GB인 RDS db.t4g.micro로 PostgreSQL을 운영하던 중, 쿼리가 지연되고 DB가 재기동하는 일이 반복됐습니다.
운영 기록을 캐시 크기별로 비교해 보니, 캐시가 적었던 구간에서 읽기량과 크레딧 감소 속도가 모두 높았습니다. 그런데 읽기량이 늘어난 정도보다 크레딧이 줄어드는 속도의 차이가 훨씬 컸습니다.
캐시가 조금 줄었을 뿐인데, 왜 크레딧은 훨씬 빨리 소진됐을까요? 전체 메모리에서 작은 차이였던 수십 MB가 얼마 남지 않은 캐시와 I/O 여유에서는 어떤 차이가 되는지 살펴봤습니다.
전체 메모리와 남은 캐시
OS는 스토리지에서 읽은 파일 내용을 메모리에 남겨 두었다가 다시 사용합니다. 이를 페이지 캐시라고 하며, 같은 내용이 필요할 때 스토리지를 다시 읽는 일을 줄여 줍니다. 메모리가 부족해 캐시에 있던 내용이 밀려나면, 다시 필요할 때 스토리지에서 읽어 와야 합니다.
메모리 용량은 편의상 GiB·MiB 대신 익숙한 GB·MB로 표기했습니다.
이 인스턴스에서 OS가 보는 전체 메모리는 약 921 MB였습니다. 그중 RDS 관리 프로세스의 RSS는 평균 약 415 MB였습니다. RSS는 프로세스가 실제 RAM에 올려 둔 페이지의 양으로, 공유 페이지가 중복으로 잡힐 수 있지만 사용량의 변화를 살펴보는 데 쓸 수 있습니다.1
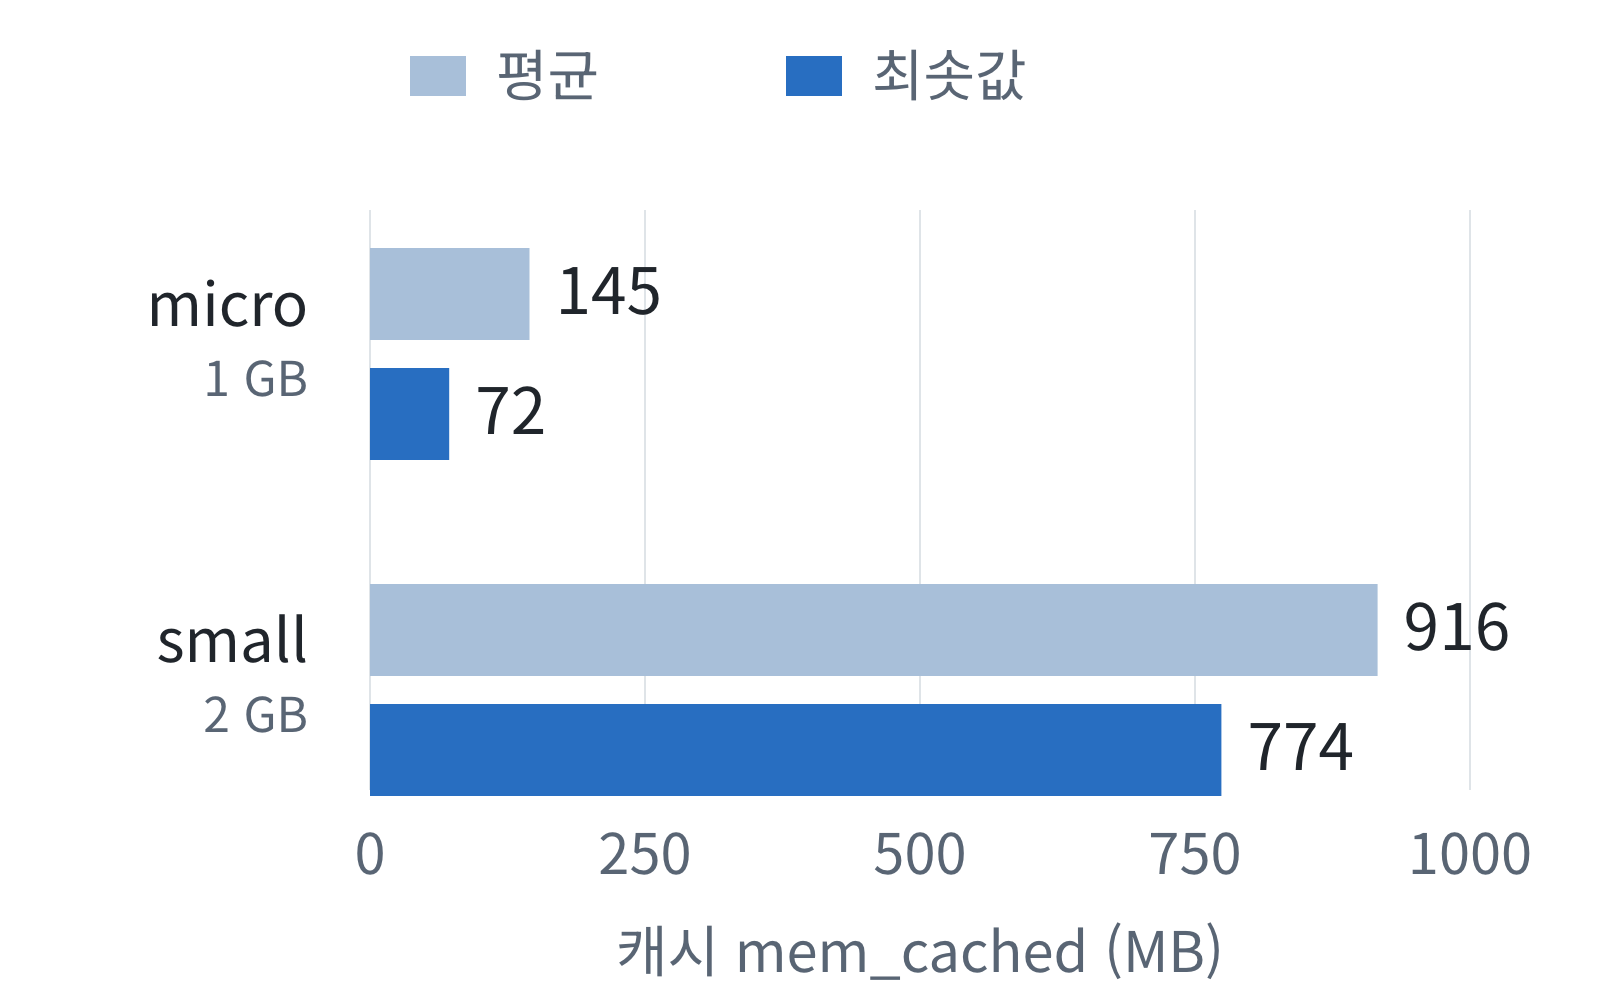
PostgreSQL의 자체 데이터 버퍼인 shared_buffers는 약 88 MB였고, OS 캐시를 나타내는 mem_cached는 평균 약 145 MB였습니다. 이 글의 캐시 크기는 이 지표를 뜻하며, PostgreSQL 공유 메모리가 일부 포함됐을 수 있습니다.
10 MB는 전체 메모리 921 MB의 약 1.1%지만, 남은 캐시 130~200 MB에서는 약 5~8%입니다. 같은 크기의 변화라도 무엇을 기준으로 보는지에 따라 비중이 달랐습니다. 파일을 다시 읽지 않고 재사용할 공간이 얼마 남지 않은 상황에서는 수십 MB를 작게 볼 수 없었습니다.
캐시 크기와 ROOT 읽기
읽기가 많이 발생한 곳은 OS와 RDS 관리 프로그램이 있는 ROOT 볼륨이었습니다. 테이블과 인덱스 등 DB 파일이 있는 DATA 볼륨과는 별개입니다.
처음에는 반복 조회 SQL을 개선했습니다. 전후 비교에서 DATA 읽기는 94% 줄었지만 ROOT 읽기는 비슷하게 남아, 쿼리가 읽는 데이터만으로 전체 부하를 설명할 수는 없었습니다.
운영 기록을 캐시 크기별로 묶어 보니 ROOT 읽기와의 관계가 드러났습니다.
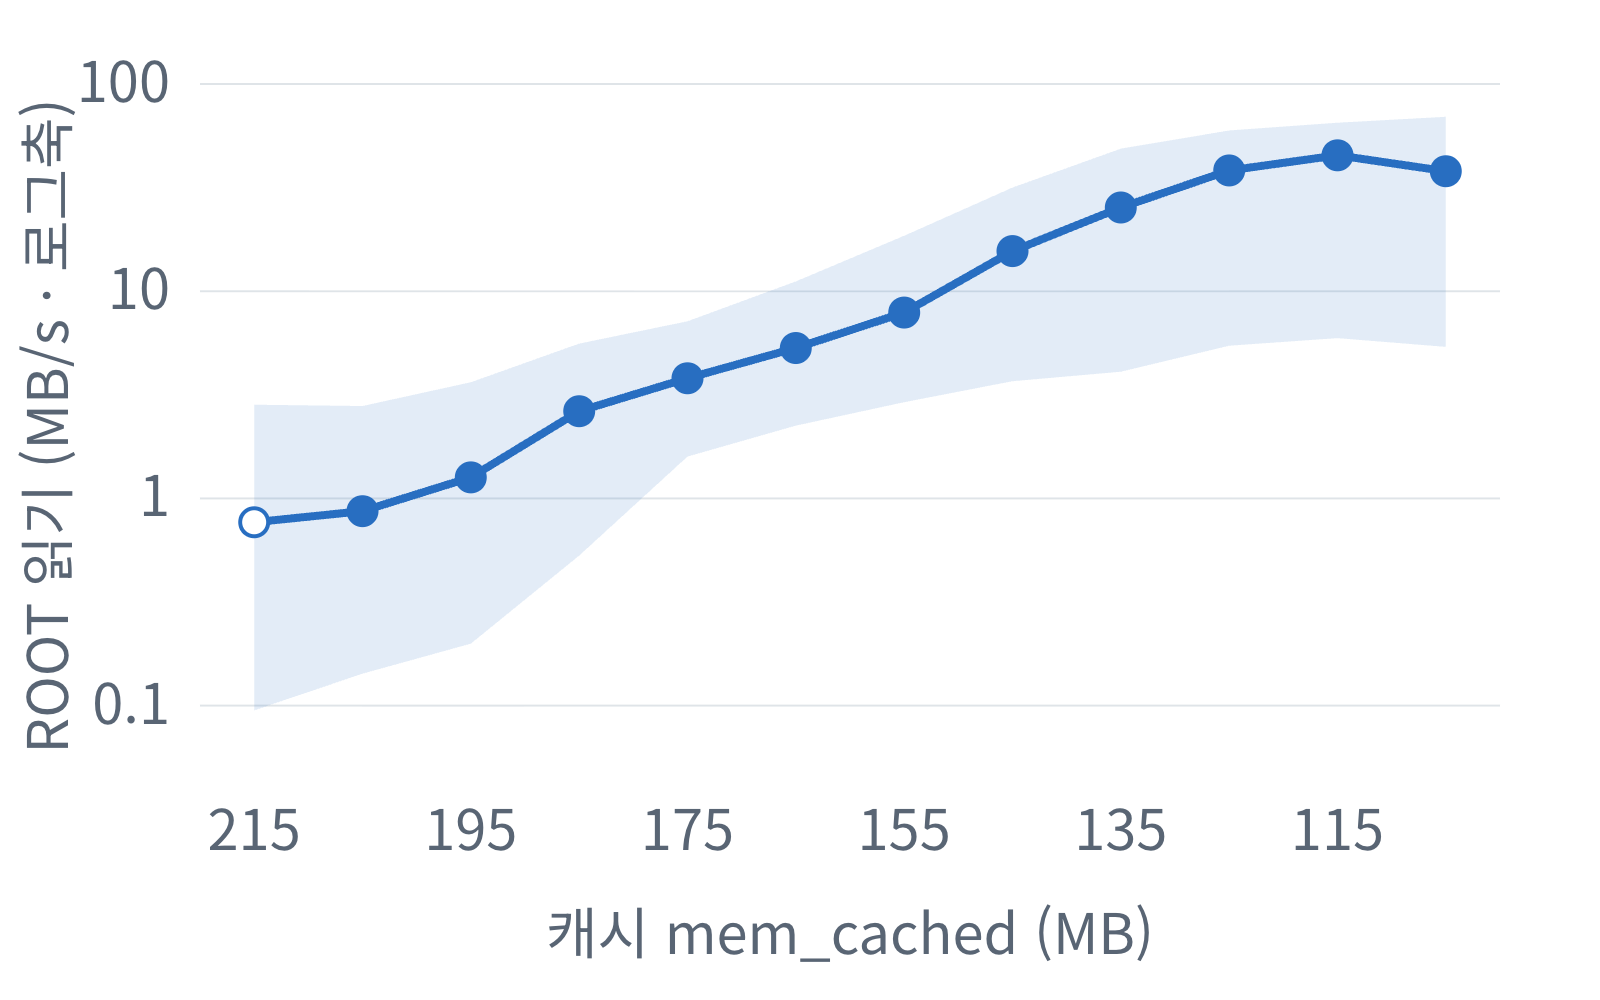
캐시가 적었던 구간에서는 ROOT 읽기가 몇 배씩 높았고, 관리 프로세스가 메모리를 돌려줘 캐시가 늘었을 때는 읽기가 줄어드는 모습도 나타났습니다. 다만 시간대와 부하도 함께 달라지므로 그 차이를 모두 메모리만의 효과로 계산할 수는 없었습니다.
ROOT 읽기의 대부분은 PostgreSQL 밖 호스트 쪽에서 발생한 것으로 보였습니다. 캐시에서 밀려난 파일·코드 페이지를 다시 읽는다는 설명과도 맞지만, 어느 프로그램이 어떤 파일을 읽었는지까지 확인한 것은 아닙니다. 재읽기의 구체적인 경로는 추정으로 남겨 뒀습니다.
기준 처리량과 크레딧 소모
읽기량이 늘었다는 사실만으로는 크레딧이 훨씬 빨리 줄어든 이유를 설명하기 어렵습니다. 차이를 이해하려면 이 인스턴스가 지속적으로 감당할 수 있는 기준 처리량을 봐야 합니다.
RDS가 참조하는 기반 EC2 사양에서 t4g.micro의 EBS 기준 처리량은 약 10.88 MB/s입니다. 이를 넘는 부하는 남은 처리량 크레딧을 사용해 일정 시간 감당할 수 있습니다. 이 글에서 말하는 크레딧은 CPU나 IOPS 크레딧과는 다릅니다.23
크레딧으로 감당해야 하는 것은 기준 처리량을 넘은 몫입니다. 기준에 가까운 상태에서는 전체 I/O가 조금 늘어도, 그 기준을 뺀 나머지는 몇 배가 될 수 있습니다.
캐시 크기별로 전체 I/O와 실제 크레딧 감소 속도를 함께 비교했습니다. 표의 소진 시간은 같은 감소 속도가 계속된다고 가정한 계산입니다.
| 캐시 구간 중심 | 전체 I/O 평균 (MB/s) | 기준 초과분 (MB/s) | 크레딧 감소 (%p/시간) | 100%→0% 시간 (환산) |
|---|---|---|---|---|
| 167.5 MB | 12.7 | 1.9 | 2.1 | 약 48시간 |
| 157.5 MB | 15.9 | 5.0 | 5.2 | 약 19시간 |
| 147.5 MB | 24.9 | 14.0 | 13.8 | 약 7시간 |
167.5 MB 구간과 157.5 MB 구간을 비교하면 전체 I/O 평균은 약 25% 늘었지만, 기준을 넘은 몫은 약 2.7배였습니다. 실제 크레딧 감소 속도도 약 2.5배였습니다. 읽기량의 증가율만 봤다면 크레딧이 얼마나 빨리 줄어드는지 놓칠 수 있었습니다.
시간대와 부하가 다른 운영 구간을 비교한 값이므로 캐시 10 MB를 줄인 실험의 결과는 아닙니다. 다만 기준 처리량 부근에서 작은 부하 차이가 크레딧 소모 속도의 큰 차이가 될 수 있다는 점은 이해할 수 있었습니다.
여기서 전체 I/O에는 ROOT와 DATA의 읽기·쓰기가 모두 들어갑니다. 이번 기록에서 CloudWatch의 ReadThroughput은 DATA 읽기와 맞았지만, 잔고를 나타내는 EBSByteBalance%는 ROOT까지 포함합니다. DATA 읽기 그래프가 낮다고 크레딧 소모도 적을 것이라고 판단할 수 없었던 이유입니다.4
크레딧 소진과 서비스 지연
기준을 넘는 동안에도 크레딧이 남아 있으면 I/O를 처리할 수 있습니다. 당장의 대기 시간이 평소 수준이어도, 같은 부하를 계속 감당할 잔고는 빠르게 줄어들 수 있었습니다.
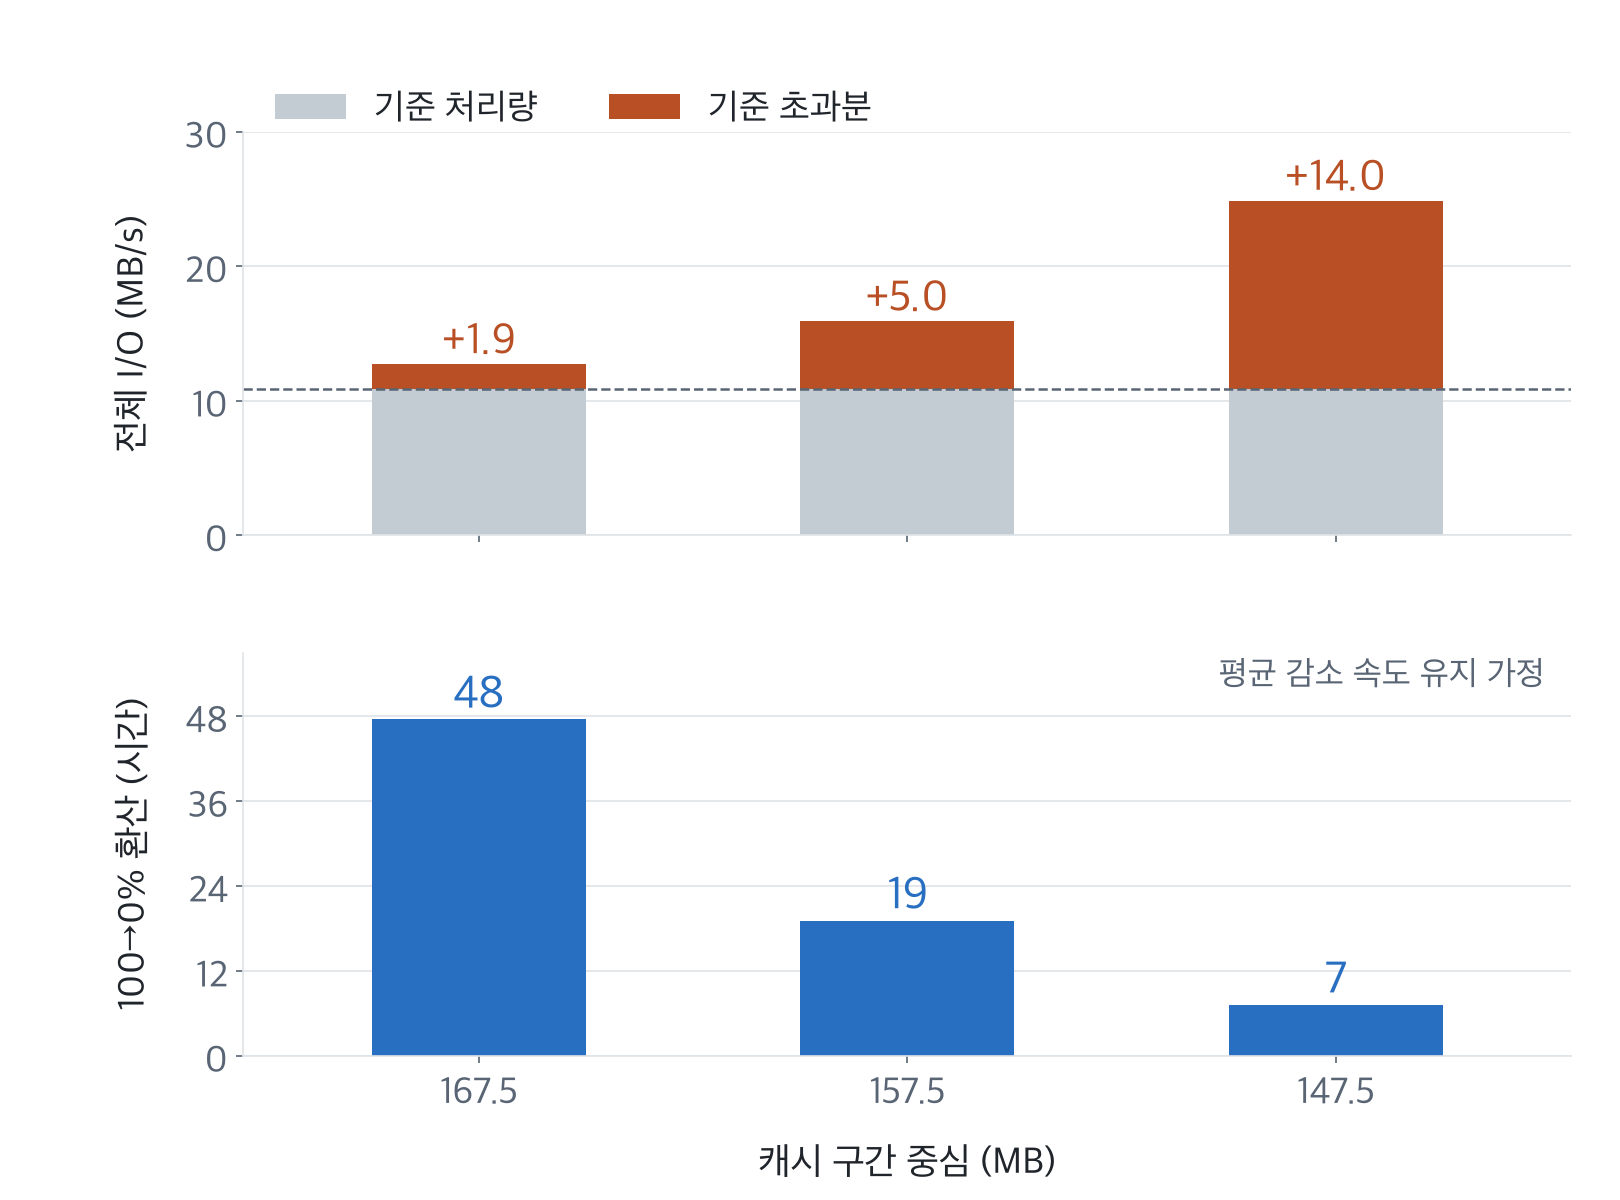
실제로는 캐시와 부하가 계속 바뀌고 크레딧도 보충될 수 있습니다. 그래프는 현재의 감소 속도가 이어진다는 가정에서, 남은 여유가 시간으로 얼마나 달라지는지 보여 줍니다.
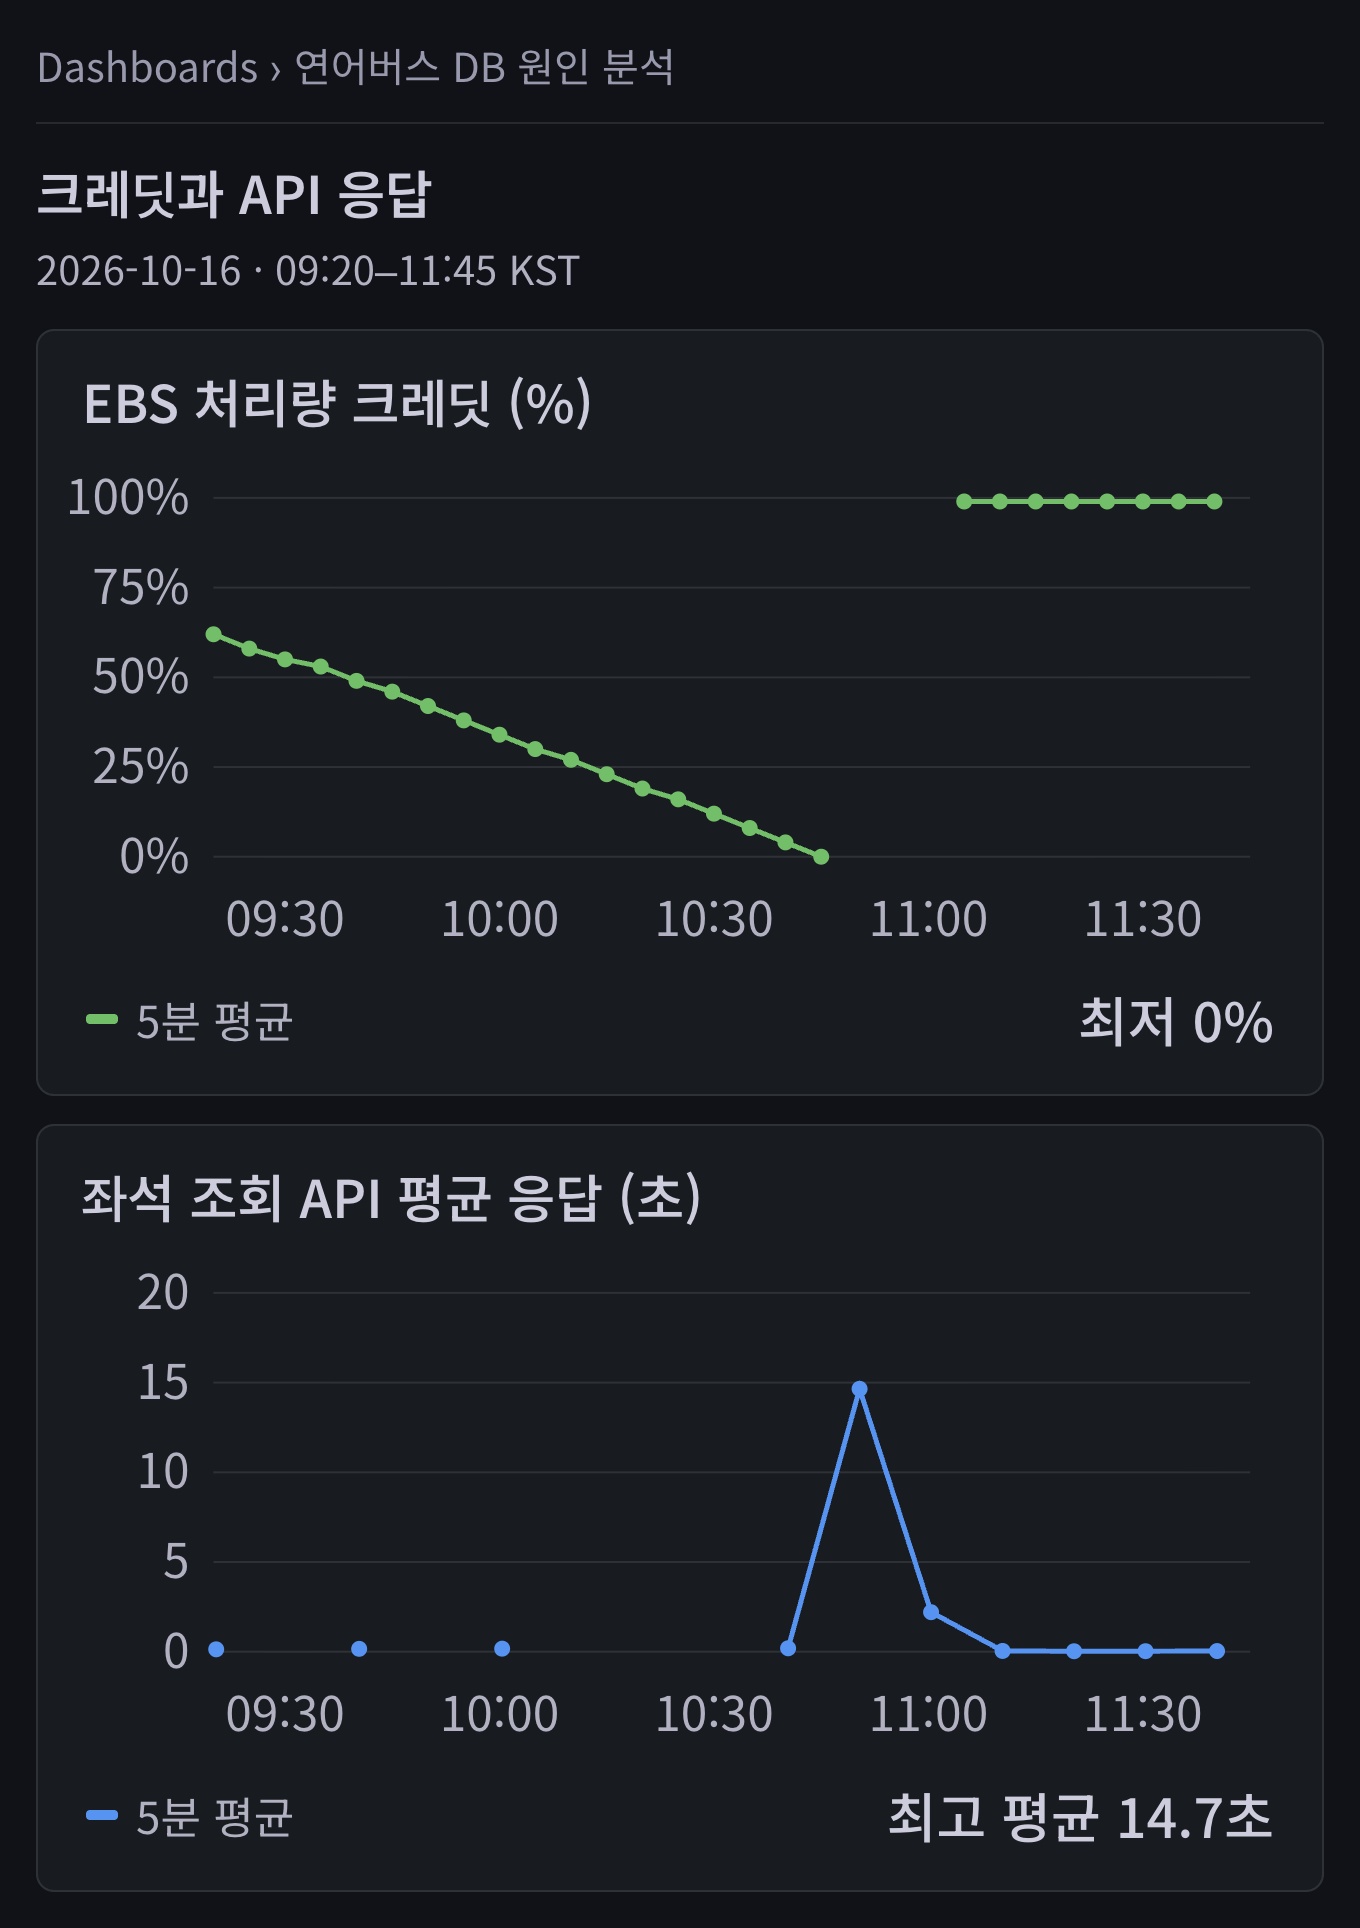
10월 12일에는 캐시가 163 MB에서 123 MB로 줄어드는 동안 ROOT 읽기가 4.3 MB/s에서 46.8 MB/s까지 올랐습니다. 오후에 99%였던 크레딧은 몇 시간 뒤 0이 됐습니다. 캐시가 줄어든 뒤 늘어난 읽기 부하가 이어지면서, 몇 시간에 걸쳐 잔고가 소진됐습니다.
API 응답에서도 지연이 나타났습니다. 10월 16일 오전, 크레딧이 0으로 기록된 무렵 좌석 조회 API의 5분 평균 응답 시간은 고갈 전 135~192 ms에서 14.7초로 늘었습니다. 당시 요청량은 분당 수 건이어서 일반적인 성능 차이로 볼 수는 없지만, 적은 요청에도 응답이 오래 걸리고 있었습니다.
아래 두 화면은 저장된 운영 기록으로 재구성했습니다. API와 커넥션 풀 지표는 10분 간격으로 저장한 값입니다.
API 서버는 미리 만들어 둔 DB 연결을 커넥션 풀에서 빌려 씁니다. 같은 구간에는 연결을 기다리는 스레드가 최대 6개였고, 5분 평균 연결 획득 대기는 약 3.7초였습니다. 연결을 얻지 못해 30초 제한에서 타임아웃된 경우도 기록됐습니다. 대기 스레드 수를 HTTP 요청 건수로 볼 수는 없지만, API 서버의 작업이 DB 연결을 기다리고 있었다는 것은 확인할 수 있었습니다.
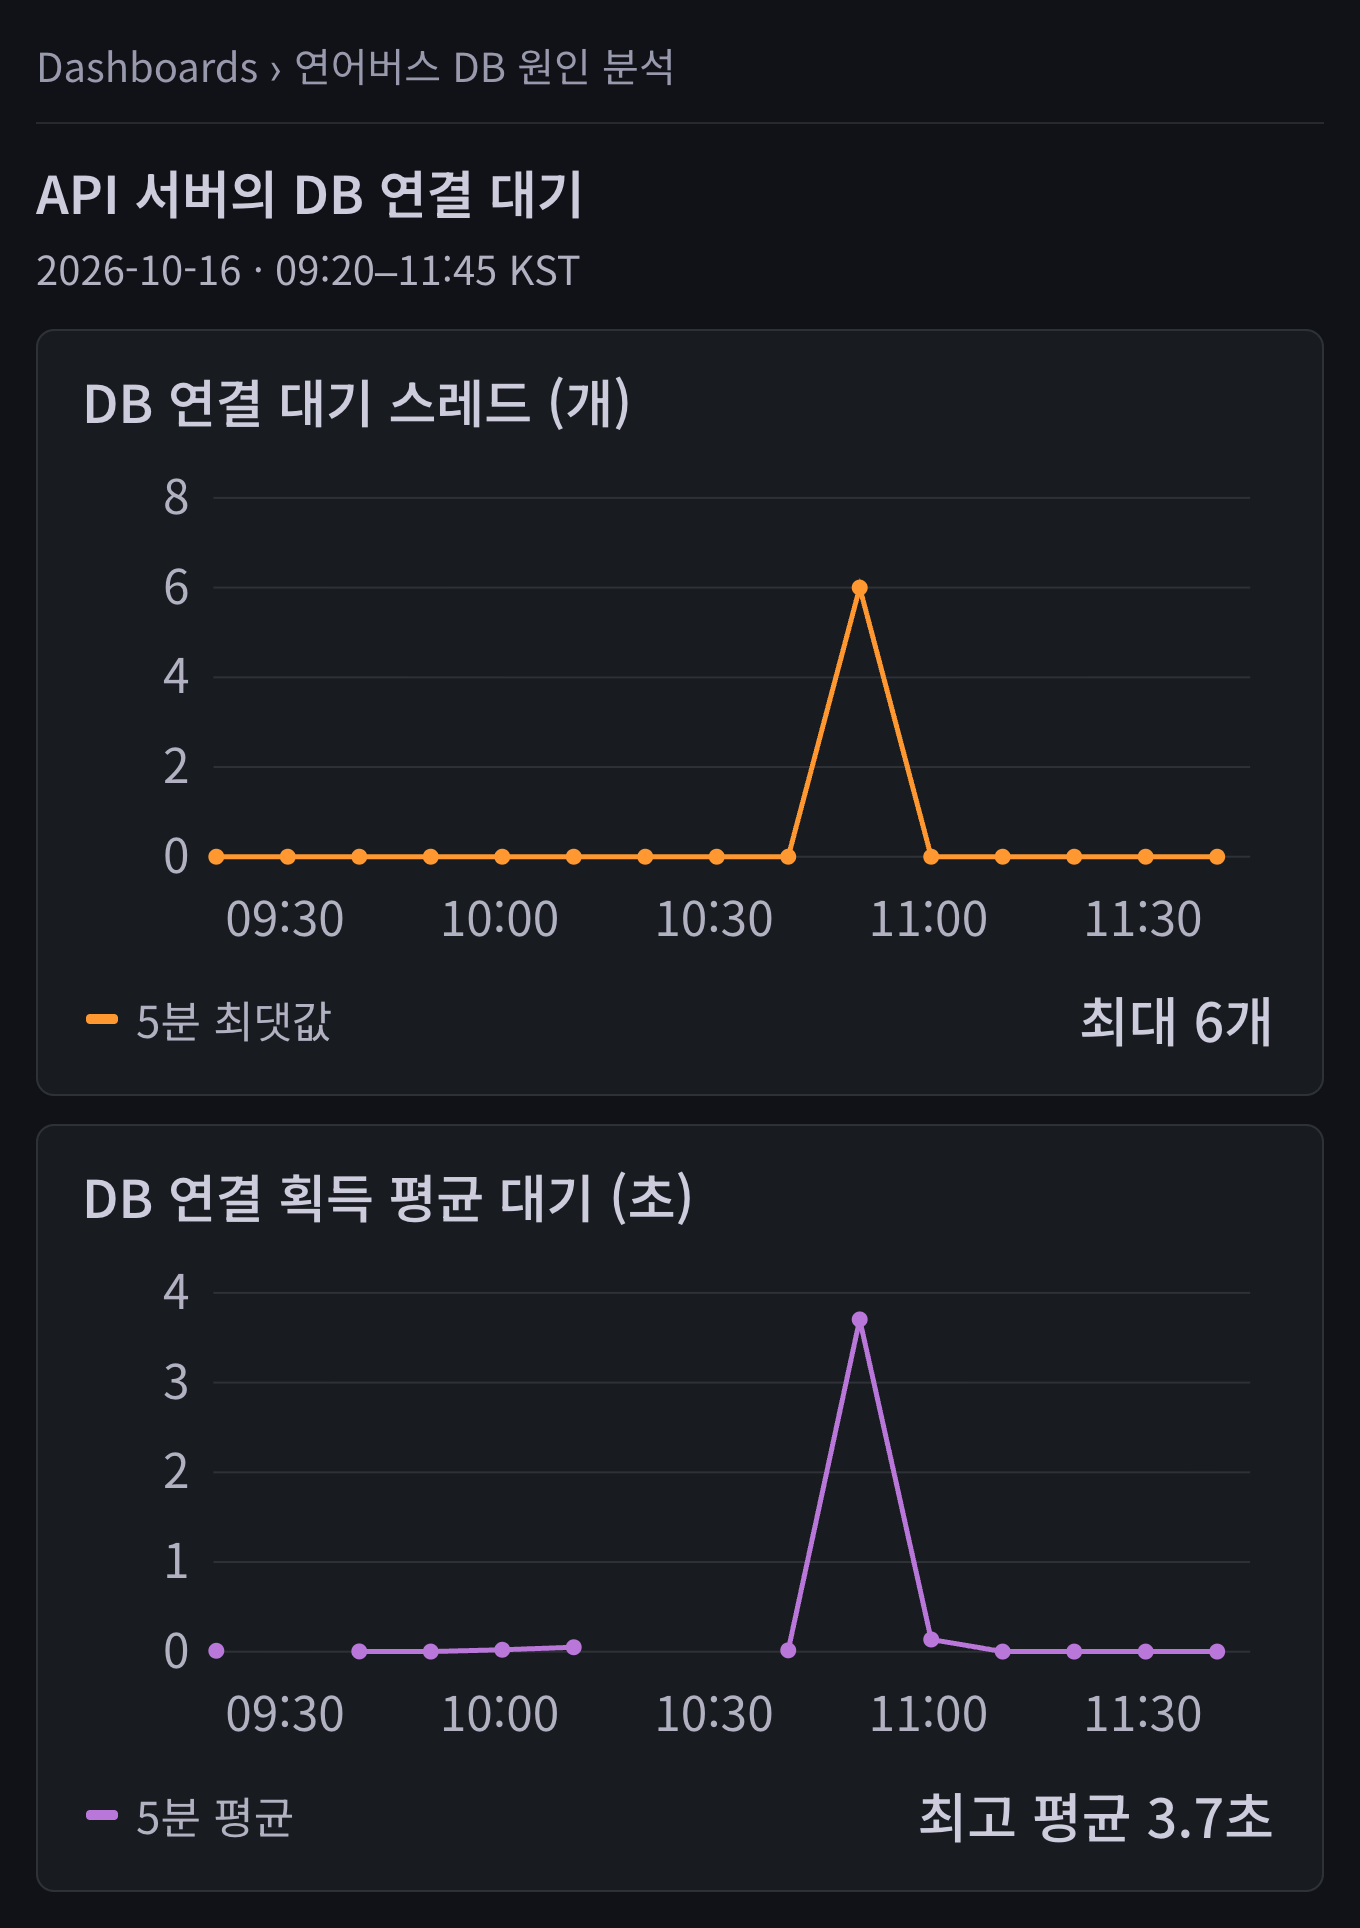
API 응답 시간에는 연결을 기다린 시간도 포함되므로, SQL 한 문장의 실행 시간이 그만큼 늘었다는 뜻은 아닙니다. 고갈 전 DB 연결 수나 PostgreSQL 메모리가 계속 늘어나는 모습은 확인되지 않았고, API 서버의 메모리는 기록이 남아 있지 않았습니다. 따라서 요청이 쌓여 RDS 메모리가 더 부족해졌다는 설명까지 이어 갈 근거는 없었습니다.
재기동 뒤의 연결 복구도 따로 확인해야 했습니다. 10월 19일에는 DB 재기동 뒤 9시간 넘는 관측 범위에서 API 풀의 연결 수 최솟값이 반복해 0으로 기록됐고, 503 오류도 발생했습니다. 표본 사이의 상태는 알 수 없어 이를 연속 장애 시간으로 계산할 수는 없었지만, DB가 돌아왔다고 API의 연결까지 회복된 것은 아니었습니다.
다만 크레딧 고갈과 첫 시간 초과의 정확한 선후관계, AWS의 내부 복구 조건까지 확인한 것은 아닙니다. 크레딧이 바닥나도 같은 장애로 이어지지 않은 사례도 있어, 잔고 하나만으로 재기동의 원인을 확정할 수는 없었습니다.
메모리 증설 전후 비교
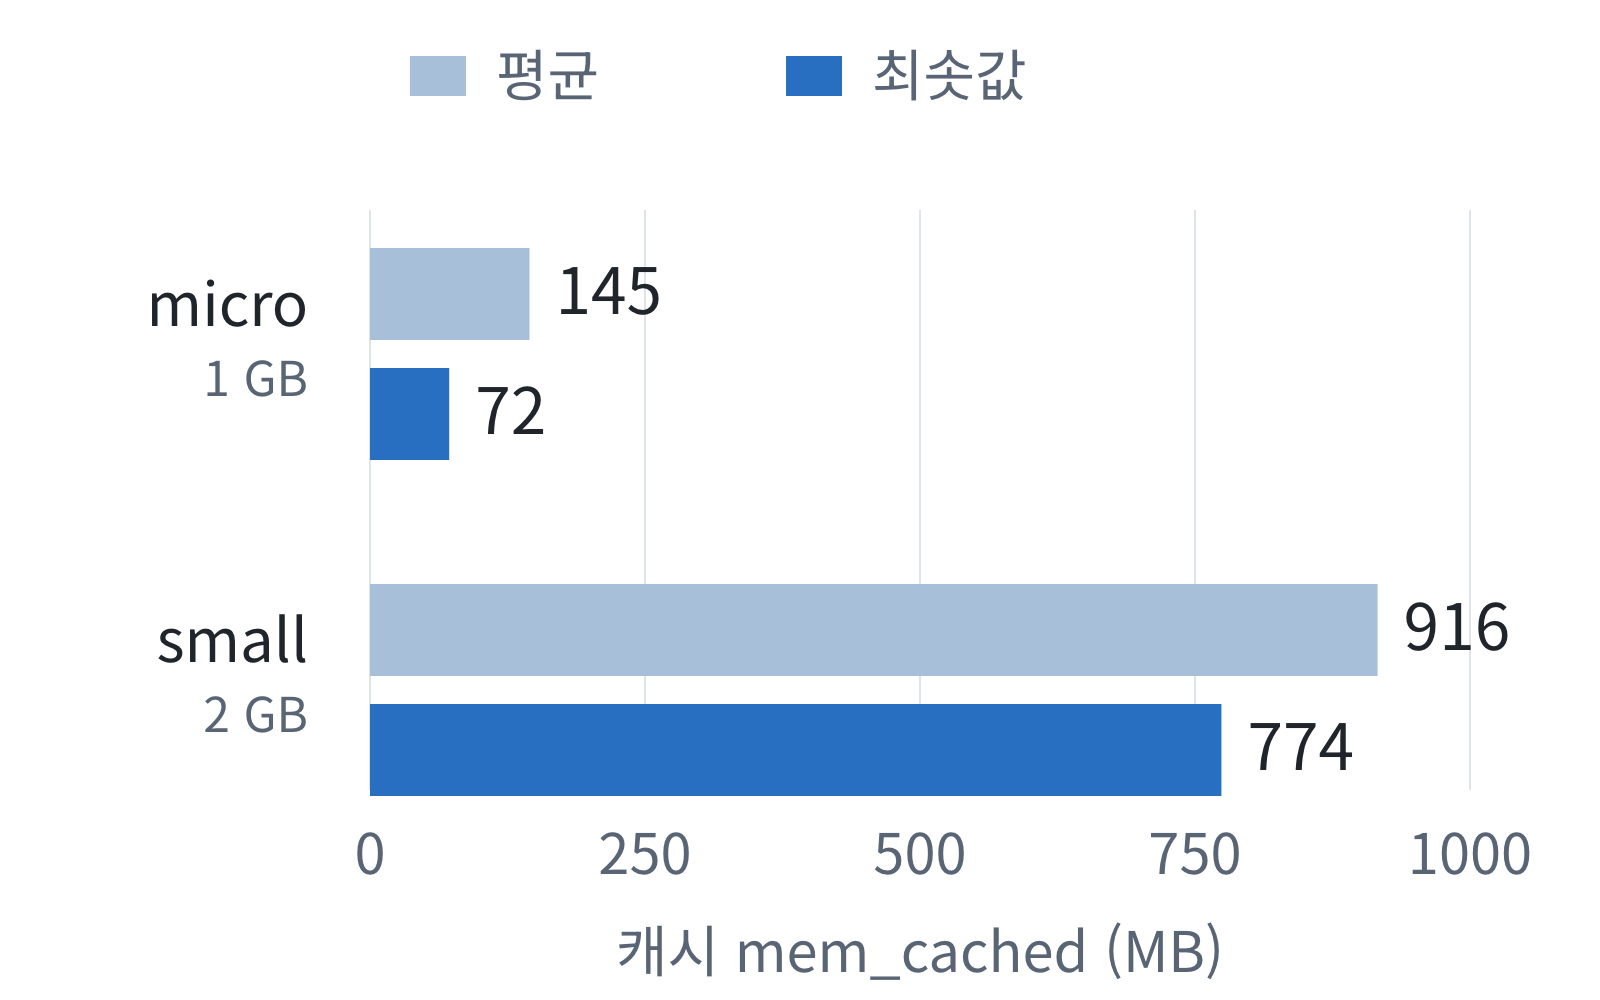
10월 19일에는 RDS를 2 GB인 db.t4g.small로 변경했습니다. 전환 직후 가득 찬 크레딧보다, 데이터 수집을 계속하는 동안 캐시와 잔고가 어떻게 유지되는지 봤습니다.
| 지표 | micro 19.5시간 | small 24.6시간 |
|---|---|---|
mem_cached 평균 | 145 MB | 916 MB |
mem_cached 최솟값 | 72 MB | 774 MB |
| ROOT 읽기 평균 | 15.7 MB/s | 0.048 MB/s |
| 처리량 크레딧 최솟값 | 0% | 99% |
| 관측한 재기동 | 1회 | 0회 |
관리 프로세스의 메모리 사용은 계속 늘고 줄었지만, small에서는 캐시 최솟값도 micro의 평균보다 훨씬 높았습니다. 관리 프로세스가 수십 MB를 더 사용해도 캐시에 남는 여유가 달랐습니다.
메모리와 함께 EBS 기준 처리량, 호스트와 관리 프로그램 구성, 저장 공간도 달라졌으므로 개선 전체를 메모리 증가의 효과로 계산할 수는 없습니다. 관측도 한 번 기동한 뒤 약 하루뿐이어서 장기 안정성은 더 확인해야 합니다.
RDS 메모리 관리의 기준
RDS에서는 DB와 OS, 관리 프로그램이 같은 메모리를 나눠 씁니다. PostgreSQL의 shared_buffers나 work_mem을 조정할 때도 설정값 하나만 볼 것이 아니라, 쿼리가 동시에 실행될 때 얼마나 많은 메모리를 쓰고 OS 캐시에는 어느 정도 공간이 남는지 함께 봐야 합니다.5
메모리가 캐시로 쓰이고 있다면 여유 메모리가 적게 보여도 정상일 수 있습니다. FreeableMemory 값만으로 판단하기보다는 SwapUsage와 디스크 읽기, 응답 시간이 함께 어떻게 변하는지 살펴보고, 메모리를 많이 쓰는 쿼리나 불필요한 동시 연결을 줄이는 것부터 시작할 수 있습니다.6
그렇게 부하를 줄여도 캐시에 남는 여유가 부족하다면 인스턴스의 메모리와 I/O 성능을 높이는 것도 고려할 수 있습니다. 변경 뒤에는 실제 부하가 이어지는 동안에도 캐시가 유지되는지 확인하고, 이번처럼 처리량 크레딧을 쓰는 환경에서는 잔고가 계속 줄고 있지는 않은지도 함께 살펴봐야 합니다.7
재기동이 있었다면 DB가 정상 기동했다는 확인에서 끝내지 않고, API 서버의 DB 연결과 실제 응답까지 회복됐는지 확인해야 합니다. 이번에는 DB의 메모리 여유를 확보하는 일과 서비스가 다시 응답하도록 만드는 일이 별개라는 점도 확인했습니다.